Diseño nativo con OTel: construir productos que exporten a cualquier stack de observabilidad
Con contribuciones de Dan Gomez Blanco (New Relic).
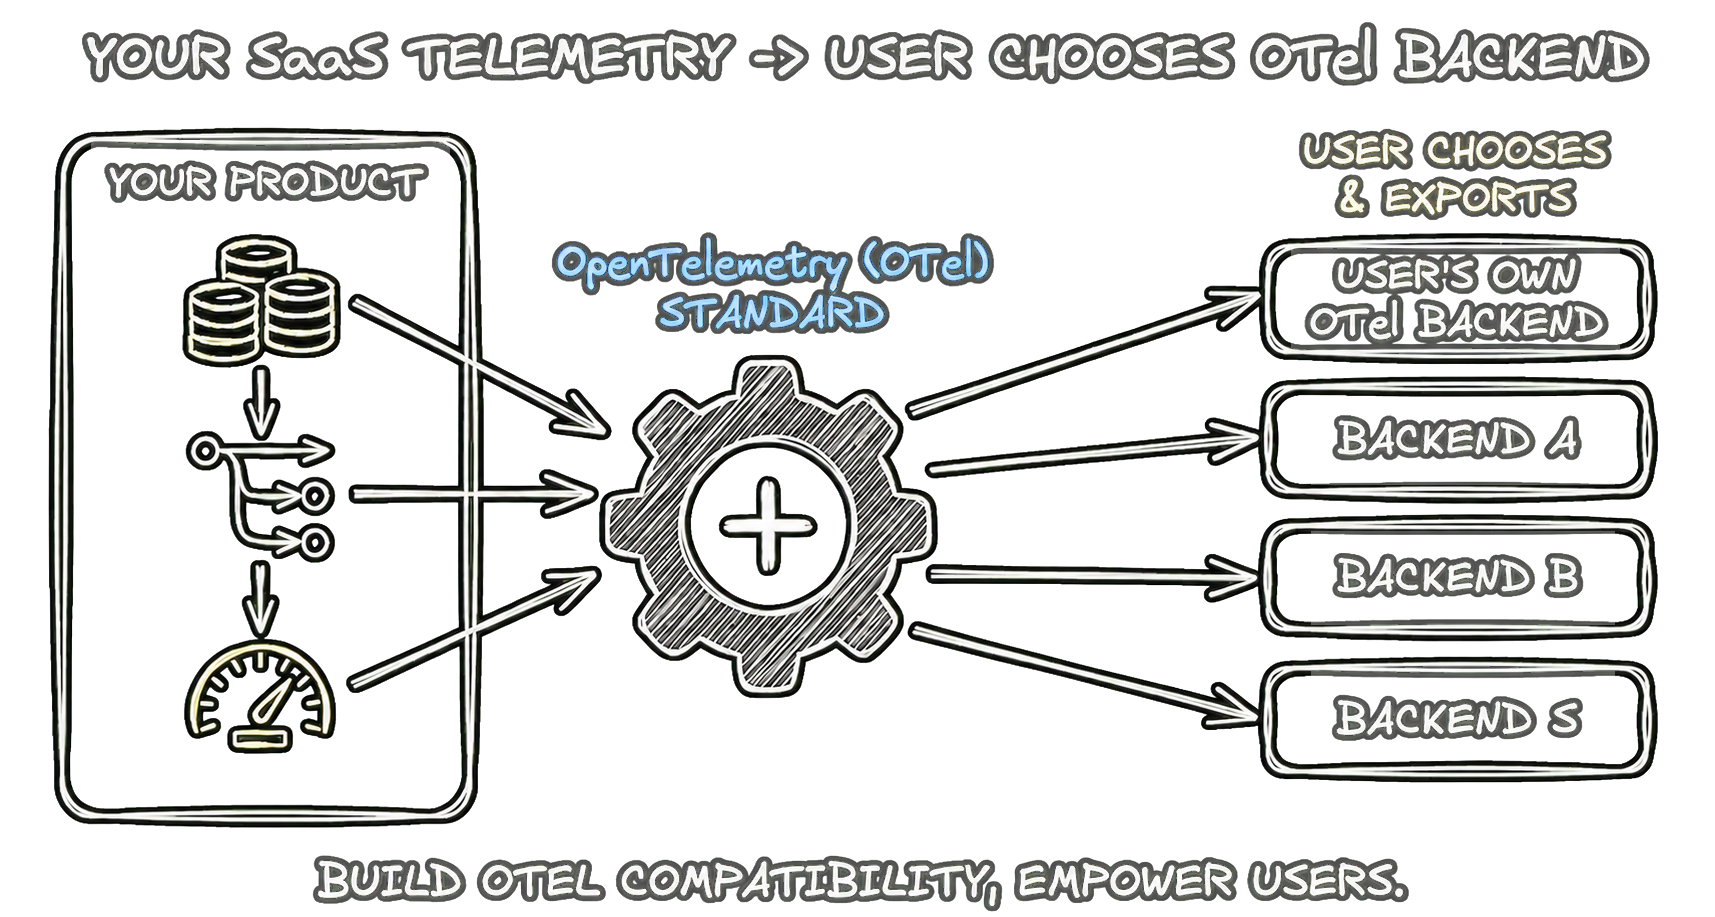
Si estás construyendo un producto self-hosted o SaaS, tus usuarios tarde o temprano van a pedir enviar logs, trazas y métricas a su propio stack de observabilidad, ya sea para cumplir requisitos normativos, gestionar costos o centralizar todos sus datos de observabilidad en un solo lugar.
Crear dependencia de tus dashboards integrados o limitar la exportación a ciertos proveedores crea fricción innecesaria. En cambio, permitir la exportación a cualquier backend compatible con OpenTelemetry (OTel) es una práctica independiente del proveedor y preparada para el futuro, que les da la libertad de escoger su stack de observabilidad.
Esta publicación describe cómo puedes diseñar tu producto para que los usuarios puedan exportar sus logs, trazas y métricas a un backend OTel cuando quieran.
Las cuatro señales de observabilidad
OpenTelemetry define cuatro tipos de señales, todas transportadas mediante el estándar OpenTelemetry Protocol (OTLP):
- Logs: Registros de eventos y logs de solicitudes, accesos y aplicaciones, con marcas de tiempo y metadatos.
- Trazas: Trazas distribuidas y spans que permiten a los usuarios ver los flujos de solicitudes entre servicios y correlacionarlos con logs.
- Métricas: Contadores, medidores e histogramas (por ejemplo, tasa de solicitudes, latencia y tasa de errores).
- Perfiles: Muestras que indican dónde consumen recursos las aplicaciones durante su ejecución.
Los perfiles entraron en fase alfa pública el 26 de marzo de 2026. Como señal, OpenTelemetry busca que los perfiles acompañen a las tres señales principales de observabilidad y ayuden a los usuarios a resolver incidentes de producción mediante la captura de patrones de uso de recursos en su código.
Aunque en esta publicación nos enfocamos exclusivamente en logs, trazas y métricas, nos entusiasma ver cómo evolucionan los perfiles y cómo los utiliza la comunidad en sus sistemas de observabilidad.
El mismo modelo de exportación se aplica a las tres señales (logs, trazas y métricas): permitir que los usuarios configuren un endpoint OTLP y enviar telemetría a él. Puedes añadir soporte para una, dos o las tres señales, según lo que genere tu producto.
Muchas plataformas que permiten exportar mediante OTel incluyen al menos trazas y logs, y cada vez más incorporan métricas. Diseñar para las tres señales desde el inicio evita tener que adaptar el sistema más adelante.
Características de un buen sistema de telemetría
Un modelo de exportación sólido tiene algunas propiedades claras para cada señal que soporta:
- Independencia del proveedor: Los usuarios pueden elegir cualquier endpoint compatible con OTel, ya sea una instancia del Collector o uno de los muchos backends que soportan OTLP directamente, sin construir integraciones personalizadas para cada uno.
- Sin desarrollo personalizado complejo: Las plataformas externas o las herramientas de tus usuarios pueden integrarse mediante los SDK de OTel estándar y el protocolo OTLP, en lugar de API propietarias.
- Preservación del contexto: Los datos exportados deben incluir metadatos, marcas de tiempo y correlación con trazas y spans cuando esté disponible (por ejemplo, registros de logs vinculados a ID de trazas), para que los usuarios puedan depurar y analizar los datos en su propio backend sin perder contexto.
- Soporte para convenciones semánticas: Seguir las convenciones semánticas asegura que la telemetría se mantenga estandarizada y sea fácil de interpretar en cualquier backend compatible. También reduce la carga cognitiva del usuario al comprender cómo funciona el sistema, ya sea propio o de terceros.
Si tu diseño sigue estos principios para las señales que emite, está alineado con la forma en que las plataformas modernas abordan la exportación de datos de observabilidad.
Dos contextos: ¿dónde se ejecuta tu producto?
La manera de añadir la exportación mediante OTel depende de quién controla el sistema que produce la telemetría. Definir esto correctamente te ayuda a elegir el enfoque adecuado.
Software self-hosted
Tu producto es una aplicación o sistema (por ejemplo, un servidor de identidad, una red de servicios o una base de datos) que los clientes instalan y ejecutan en su entorno: su centro de datos, su nube o su clúster de Kubernetes.
Aquí, tú instrumentas tu producto con OpenTelemetry. Cuando un cliente configura el endpoint (por ejemplo, mediante variables de entorno o un archivo de configuración), tu aplicación exporta la telemetría desde el proceso que ejecuta el cliente.
Como OpenTelemetry proporciona opciones de configuración estándar, tus usuarios pueden esperar la misma experiencia de configuración que ya conocen de otros sistemas instrumentados con OTel.
La exportación sucede en el entorno del cliente; este controla el binario y el destino. Ejemplos: Keycloak y Kuma.
Plataformas en la nube
Tu producto es una plataforma donde los clientes despliegan sus propias aplicaciones o utilizan tus servicios gestionados (por ejemplo, PaaS, serverless o una puerta de enlace de API). La carga de trabajo se ejecuta en tu infraestructura.
Aquí, añades una funcionalidad de la plataforma, como “Telemetry Drains” u “Observability Destinations”, que permite a los clientes configurar dónde enviar la telemetría. Tu plataforma recopila la telemetría de sus cargas de trabajo y de tus propios servicios, como los enrutadores, y la envía al endpoint OTLP que configure el cliente.
La exportación se realiza desde tu infraestructura, no desde un binario que ejecuta el cliente. Ejemplos: Heroku y Cloudflare.
En resumen, software que despliega el usuario → enfoque en instrumentación integrada y configuración de un endpoint. Una plataforma que tú operas → enfoque en destinos de exportación configurables a los que tu infraestructura envía los datos.
Cómo lo hacen otros
Esta publicación se enfoca en cuatro integraciones (Kuma, Keycloak, Cloudflare y Heroku) como ejemplos representativos de los dos contextos anteriores, pero no son las únicas que exportan telemetría nativamente mediante OTLP. En OpenTelemetry Integrations puedes encontrar bibliotecas y servicios con instrumentación nativa o plugins de primera clase.
A continuación, se muestra cómo estas cuatro integraciones manejan las tres señales o un subconjunto de ellas, y qué podemos aprender de sus enfoques.
| Plataforma | Logs | Trazas | Métricas | Modo de despliegue | Notas |
|---|---|---|---|---|---|
| Kuma | Sí | Sí | Sí | Software que el usuario despliega | Políticas separadas por señal, todas con OTel |
| Keycloak | Sí† | Sí | Sí | Software que el usuario despliega | †Logs en versión preliminar; mismo endpoint para todas |
| Cloudflare Workers | Sí | Sí | No* | Plataforma | *Exportación de métricas aún no disponible |
| Heroku | Sí | Sí | Sí | Plataforma | El usuario escoge las señales con --signals |
El enfoque self-hosted: Kuma y Keycloak
Si tus usuarios despliegan tu software en sus propios entornos, la mejor práctica es entregar la aplicación ya instrumentada con OpenTelemetry y exponer opciones de configuración para sus endpoints OTLP.
Kuma
Tanto si los clientes ejecutan los planos de control y de datos de Kuma en sus propios clústeres de Kubernetes como en máquinas virtuales, Kuma viene preconfigurado para emitir logs, trazas y métricas a un backend OTel.
Los usuarios configuran la exportación desde sus despliegues de Kuma mediante las políticas de la malla:
- MeshAccessLog: Envía los logs de acceso a un Collector de OTel, con un endpoint y atributos como el nombre de la malla y la hora de inicio.
- MeshTrace: Gestiona las trazas distribuidas con muestreo y etiquetado configurables.
- MeshMetric: Expone métricas de los planos de control y de datos. Se integra con OpenTelemetry y Prometheus.
Por ejemplo, enviar trazas a un backend OTel quedaría así:
# MeshTrace policy
backends:
  - type: OpenTelemetry
    openTelemetry:
      endpoint: otel-collector:4317
Enviar logs de acceso sigue el mismo patrón con una política diferente:
# MeshAccessLog policy
backends:
  - type: OpenTelemetry
    openTelemetry:
      endpoint: otel-collector:4317
body:
  kvlistValue:
    values:
      - key: mesh
        value:
          stringValue: '%KUMA_MESH%'
attributes:
  - key: start_time
    value:
      stringValue: '%START_TIME%'
Para más detalles:
- Kuma MeshAccessLog: OpenTelemetry
- Kuma MeshTrace (backend OpenTelemetry)
- Observabilidad en Kuma
Keycloak
Keycloak es otro ejemplo de software self-hosted que permite exportar telemetría.
En lugar de requerir un sidecar independiente o una funcionalidad de plataforma, los usuarios pasan una opción al iniciar el proceso para apuntar al endpoint de su Collector, y el propio proceso de Keycloak se encarga de exportar los datos.
Utiliza un único endpoint de telemetría, pero ofrece opciones específicas para activar o desactivar cada señal:
- Trazas:
tracing-enabled=true(incluye solicitudes HTTP, bases de datos, LDAP y solicitudes HTTP salientes a proveedores de identidad). - Métricas: Expone métricas detalladas mediante la misma integración con OTel.
- Logs: Actualmente en versión preliminar y deshabilitados por defecto
(
--features=opentelemetry-logs --telemetry-logs-enabled=true, con--telemetry-logs-levelpara filtrar por nivel).
La configuración del endpoint, con soporte para cabeceras opcionales y elección del protocolo (gRPC o HTTP), quedaría así:
bin/kc.sh start --telemetry-endpoint=http://my-otel-endpoint:4317 --telemetry-protocol=grpc
Para más detalles:
Ambos modos de despliegue comparten un patrón recurrente.
La exportación mediante envío activo de datos con OTel/OTLP es el enfoque
práctico y preferido. Algunos productos exponen un único endpoint para las
tres señales, como Keycloak, mientras que otros permiten al usuario escoger
qué señales enviar, como Heroku con --signals.
Soportar nativamente todas las señales de telemetría da a los usuarios más flexibilidad para construir una imagen completa en el backend de su preferencia.
El enfoque de plataforma: Cloudflare y Heroku
Cuando controlas la infraestructura, una experiencia de usuario sencilla consiste en gestionar la exportación desde la plataforma, recopilando datos de las cargas de trabajo del usuario y enviándolos a su destino.
Cloudflare Workers
Como los usuarios ejecutan su código directamente en la infraestructura de Cloudflare, la plataforma gestiona la exportación mediante Observability Destinations. Los usuarios pueden configurar un endpoint OTLP en su dashboard. Desde ahí, Cloudflare envía automáticamente las trazas y los logs de Workers a ese destino.
Aunque la exportación de métricas aún no está disponible, las trazas ofrecen
visibilidad de extremo a extremo al registrar las llamadas a los manejadores,
los enlaces a recursos (bindings), las solicitudes salientes y más. Los usuarios
también pueden configurar la tasa de muestreo en wrangler.toml.
Para más detalles:
Heroku
Heroku adopta un enfoque algo diferente y muy configurable con Telemetry Drains. Los usuarios añaden un destino especificando el endpoint, el protocolo de transporte y las cabeceras, y luego escogen explícitamente qué señales exportar.
La plataforma de Heroku recopila los datos de la aplicación del usuario (mediante el SDK de OTel) y de sus propios servicios, como Router, y los envía al destino.
heroku telemetry:add <endpoint> --app <app-name> --signals traces,metrics,logs --transport http --headers '{"Authorization": "ingestion key"}'
Dar a los usuarios control granular sobre las señales que exportan es un patrón de diseño práctico, especialmente para equipos que buscan gestionar el volumen de datos y los costos de ingesta.
Para más detalles:
Diseñar tu modelo de exportación
Para las tres señales esenciales de telemetría, la pregunta fundamental de arquitectura es la misma: ¿tu plataforma requerirá que el usuario consulte una API periódicamente para obtener los datos, o entregará la telemetría directamente al endpoint que el usuario defina?
El modelo clásico: consultas periódicas a APIs personalizadas
Tradicionalmente, las plataformas han expuesto telemetría mediante API. El usuario debe consultarlas a intervalos regulares, gestionar la paginación e ingerir los resultados en sus propios backends.
Es un punto de partida razonable si ya cuentas con una API madura y probada para logs o métricas, ya que extenderla suele ser más fácil que construir un nuevo mecanismo de envío. Sin embargo, tiene costos reales:
- Trasladas una parte importante de la carga operativa al usuario. Este debe construir un sistema de consultas escalable que gestione los intervalos de consulta, la paginación de respuestas de la API, los reintentos ante fallos y la recuperación de datos faltantes.
- Los usuarios pueden construir soluciones personalizadas que no escalen, no sigan tus estándares y requieran mantenimiento significativo a medida que el esquema de la API evolucione junto con tu plataforma.
- Entregar datos casi en tiempo real se vuelve mucho más difícil, aunque suele ser un requisito para señales sensibles a la latencia, como trazas y métricas.
Para logs, una implementación basada en consultas suele tener este aspecto (por ejemplo, al estilo de CloudWatch Logs):
state: last_end_time
every poll_interval:
  start_time = last_end_time
  end_time   = now()
  next_token = null
  do:
    response = FilterLogEvents(log_groups, start_time, end_time, next_token)
    emit(response.events)
    next_token = response.nextToken
  while next_token != null
Necesitarías una lógica similar de seguimiento del estado para las API de métricas o trazas.
Aunque obliga a los usuarios a escribir código personalizado para convertir las respuestas de tu API a formatos estándar, este modelo de consultas es viable para todas las señales que soportes cuando no puedas utilizar un enfoque más estandarizado, como Prometheus.
Sin embargo, para diseños nuevos, este no debería ser el enfoque predeterminado.
El enfoque basado en estándares: OTLP
Para la telemetría en tiempo real orientada a desarrolladores, el envío mediante OTLP se ha convertido en el patrón dominante.
En lugar de esperar una consulta, tu servicio o un OpenTelemetry Collector que tú gestionas exporta activamente logs, trazas y métricas al endpoint que configure el usuario, mediante OTLP sobre HTTP o gRPC.
Utiliza un único protocolo estándar e independiente del proveedor para toda la telemetría, lo que evita tener que reimplementar la lógica de entrega para cada señal que soportes.
Además, OTLP ofrece soporte nativo para datos estructurados y metadatos, lo que ayuda a preservar el contexto, por ejemplo, al vincular registros de logs específicos con los ID de sus trazas.
Desde la perspectiva del usuario, es prácticamente plug and play. Cualquier backend compatible con OTel puede ingerir los datos casi en tiempo real sin requerir lógica de consultas personalizada.
Construir la experiencia de exportación
Al implementar el modelo de exportación en tu producto, busca maximizar la flexibilidad con una configuración mínima.
Permite que los usuarios configuren un endpoint OTLP
Empieza dejando que los usuarios proporcionen su propio endpoint OTLP y las cabeceras de autenticación necesarias, como una clave de ingesta.
¡Pero eso no es todo!
Para que los usuarios puedan controlar el volumen de exportación, simplificar la gestión de datos y reducir costos, permite que activen o desactiven explícitamente las señales que desean exportar, siguiendo el ejemplo de Heroku.
Estandariza la arquitectura
Internamente, tienes dos opciones principales: usar el SDK de OpenTelemetry directamente en tus servicios para emitir datos, o ejecutar un Collector de OTel interno que recopile la telemetría de tu sistema y la exporte al endpoint del usuario.
Usar las variables de entorno estándar de OpenTelemetry, como
OTEL_EXPORTER_OTLP_ENDPOINT,
hace que el funcionamiento interno sea confiable y fácil de documentar y
comprender.
Mantén una semántica consistente
Además de usar variables de entorno basadas en OTel, mantén una semántica consistente en todas tus señales. Las convenciones semánticas son la referencia para nombrar atributos y esquemas de forma consistente, y para relacionar los logs y las métricas con los ID de trazas y spans.
Weaver se basa en las convenciones semánticas y te permite definir tus propios nombres de atributos y esquemas, mantenerlos sincronizados con la evolución de tu código e infraestructura y gestionar registros federados de convenciones semánticas.
Cuando un usuario ingiere tu telemetría en su backend de observabilidad, todo debería conectarse de extremo a extremo para ofrecer una visión completa.
Un beneficio de este enfoque es que evitas construir integraciones diferentes para cada proveedor. Al exportar la telemetría mediante OTLP, permites que los usuarios la transformen e ingieran en los formatos que necesiten.
Por ejemplo, un usuario podría querer enviar logs tanto a su backend como a un almacenamiento de objetos, como S3, para cumplir requisitos normativos.
Enrutar la telemetría al usuario
Al diseñar la interfaz de configuración, necesitas decidir qué tan granular será el enrutamiento de la telemetría. Generalmente tienes dos opciones, cada una para necesidades diferentes.
Un solo endpoint
Para la gran mayoría de los usuarios, configurar un único endpoint es lo ideal.
En este caso, el usuario configura una URL base y el exportador agrega
internamente las rutas OTLP estándar (v1/traces, v1/metrics y v1/logs)
cuando se usa OTLP sobre HTTP.
Endpoints por señal
Los clientes de gran escala o aquellos con sistemas de observabilidad complejos pueden querer enviar señales a diferentes plataformas.
OTLP soporta este modelo mediante variables de entorno específicas para cada
señal, con el patrón OTEL_EXPORTER_OTLP_<SIGNAL>_ENDPOINT, junto con las
configuraciones de cabeceras
correspondientes. Por ejemplo, para configurar un endpoint específico para logs,
puedes usar
OTEL_EXPORTER_OTLP_LOGS_ENDPOINT.
Exponer este control por señal en tu aplicación es técnicamente opcional, pero aporta valor para los usuarios avanzados.
Ejecutar Collectors para gestionar entornos multitenant
Una vez que envías telemetría mediante OTLP, con cualquier combinación de logs, métricas o trazas, debes decidir cómo ejecutar los Collectors para gestionar entornos multitenant.
La arquitectura del Collector necesita escalar en dos dimensiones: la incorporación de más usuarios y el volumen de telemetría que se genera al añadir funcionalidades.
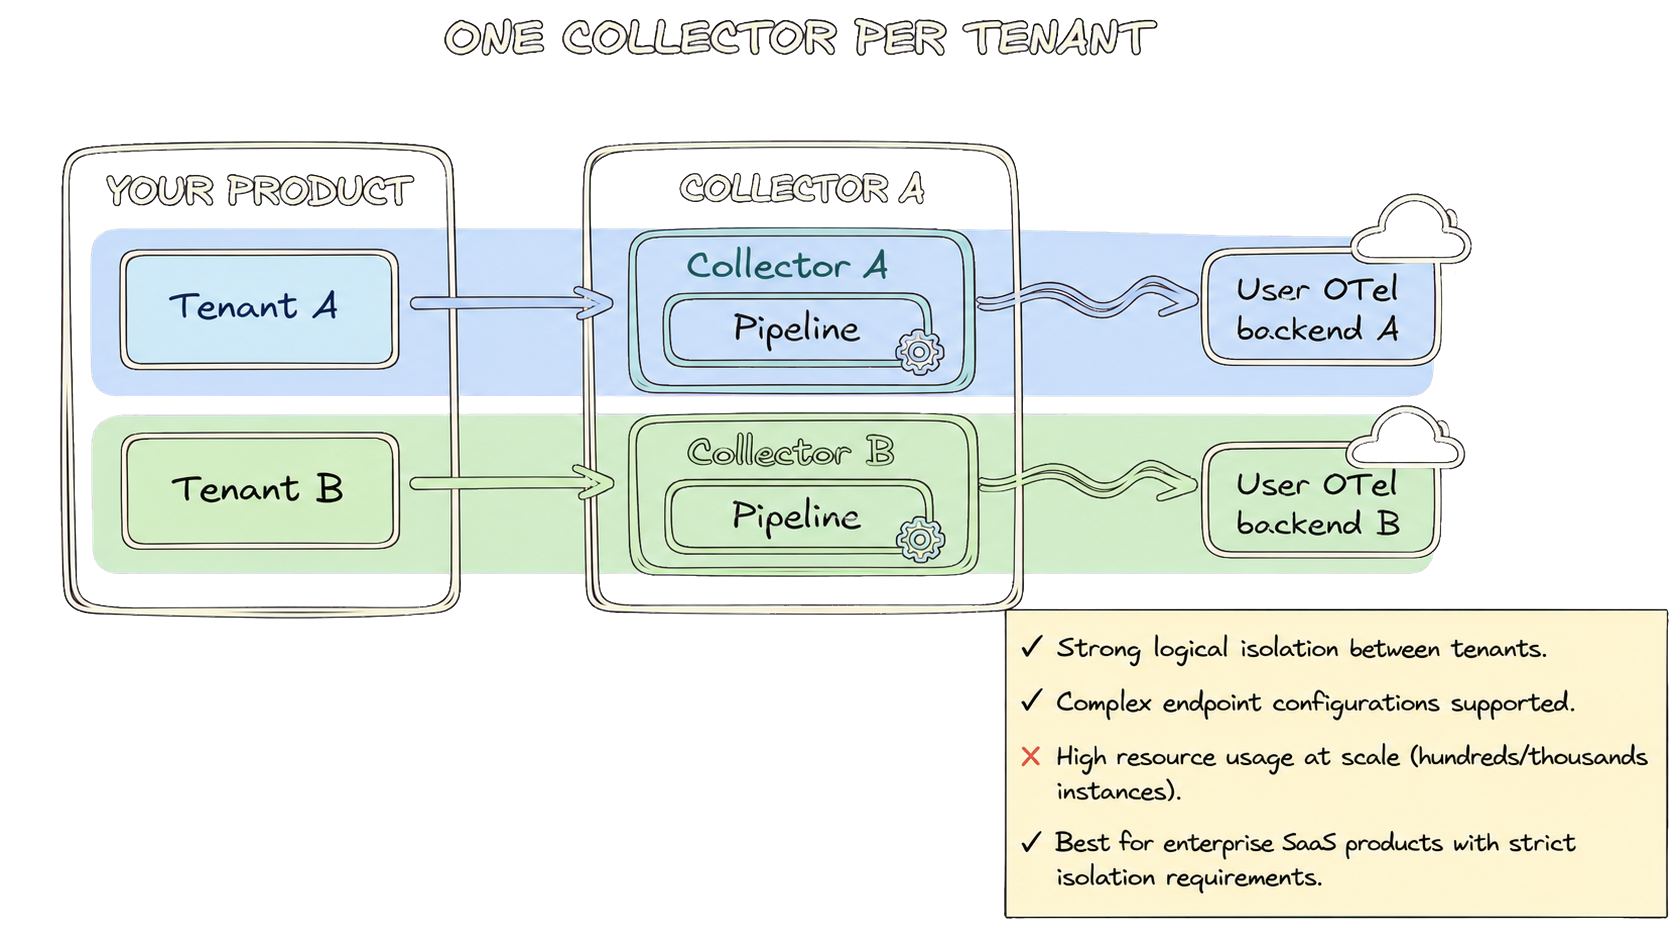
Un Collector por tenant
Si tu arquitectura ya aísla a los tenants en la infraestructura, puedes desplegar una instancia del Collector dedicada a cada cliente. En este caso, cada instancia tiene una configuración propia que apunta directamente al endpoint de exportación de ese cliente.
Este modelo ofrece garantías sólidas de aislamiento lógico. La lentitud o los errores de configuración en el pipeline de un cliente no afectan a los demás.
Aunque puedes construir un binario personalizado del Collector que solo incluya los componentes necesarios, desplegar cientos o miles de instancias consumirá muchos recursos.
Por este compromiso entre aislamiento y consumo de recursos, la arquitectura suele ser más adecuada para productos SaaS empresariales donde el aislamiento entre tenants es un requisito estricto y los clientes pueden tener configuraciones de endpoints complejas.
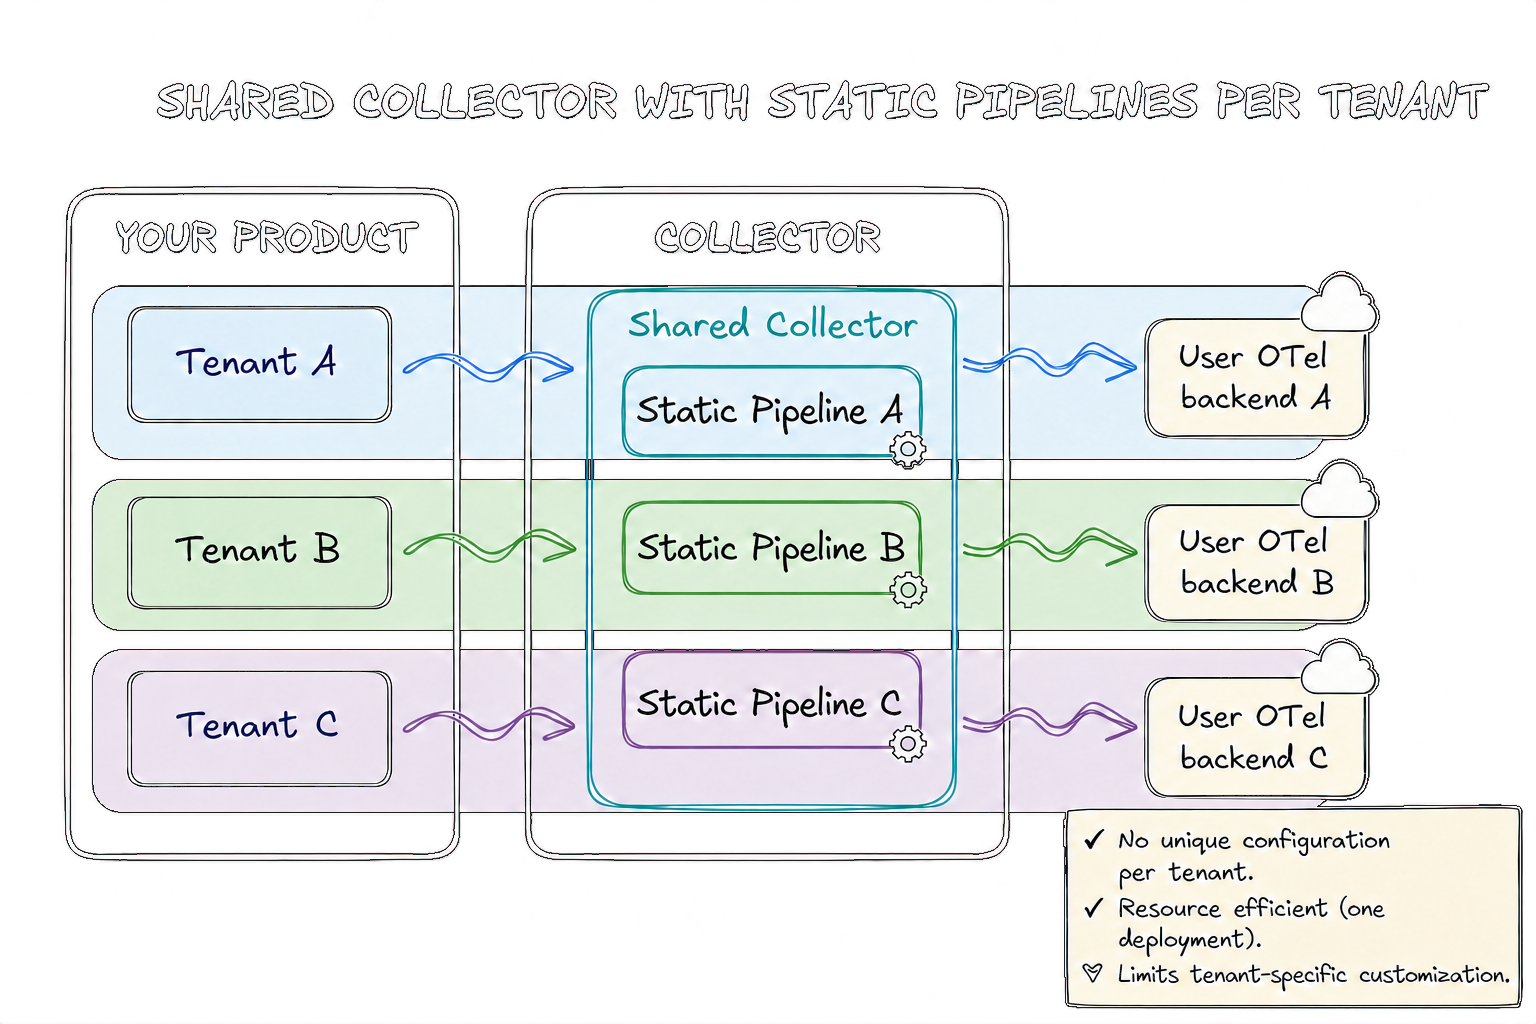
Un Collector compartido con pipelines estáticos por tenant
Aquí, “estático” significa que el pipeline y las reglas de enrutamiento de cada tenant se definen de antemano en el archivo de configuración del Collector, en lugar de crearse dinámicamente durante la ejecución.
Este enfoque se parece al patrón de despliegue tipo gateway: toda la telemetría de tu plataforma pasa por un Collector centralizado. Dentro de él, defines pipelines separados por tenant. El conector de enrutamiento encaja de forma natural aquí, dirigiendo los datos al pipeline correcto y, por lo tanto, al endpoint externo correspondiente, según atributos de recursos como el ID del tenant.
Este patrón funciona bien para equipos en etapas iniciales o de escala moderada, donde operar un único despliegue es más sencillo que gestionar instancias por tenant. Solo tienes que supervisar y escalar un despliegue, y todo el enrutamiento se configura en un solo lugar.
Sin embargo, debes estar preparado para gestionar un archivo de configuración dinámico que crecerá a medida que aumente tu base de clientes.
Consultas periódicas a APIs personalizadas vs. OTLP: ¿cuál elegir?
Cuando la elección es entre hacer que tus usuarios consulten API personalizadas o permitirles ingerir datos mediante un estándar compartido, la mayoría de las plataformas modernas orientadas a desarrolladores deberían escoger la segunda opción. Las API de consulta personalizadas son viables si la estandarización no es una opción.
El protocolo unificado de OpenTelemetry preserva el contexto, entrega datos casi en tiempo real y ha demostrado funcionar a escala en despliegues en la nube y self-hosted, como los de Cloudflare, Heroku, Kuma y Keycloak. Además, la independencia del proveedor permite a los usuarios cambiar de backend de observabilidad según las necesidades del negocio sin rehacer por completo sus pipelines de telemetría.
La adopción de OpenTelemetry tampoco está exenta de esfuerzo: tu equipo debe invertir tiempo en aprender a implementarlo y construir la documentación necesaria para guiar a los usuarios y equipos internos en las mejores prácticas.
Dada la creciente adopción de OTel en observabilidad, con su reciente graduación en la CNCF, esta inversión inicial dará resultados al integrar en tu plataforma herramientas que dependan de OpenTelemetry para exportar su propia telemetría.
Uniendo todas las piezas
En conclusión, no necesitas construir integraciones a medida para que tus usuarios exporten telemetría a sus propios backends.
Si ya estás listo para implementar la exportación nativa con OTel en tu aplicación, estos son los puntos clave de arquitectura y diseño:
- Decide qué señales de telemetría vas a soportar: logs, trazas y métricas. Idealmente, soporta las tres, pero empieza con las que genere tu producto.
- Usa OTLP para exportarlas mediante el SDK de OTel o un Collector. La misma arquitectura de envío activo funciona para las tres señales.
- Permite que el usuario configure un endpoint de destino y cabeceras de autenticación opcionales. Considera endpoints por señal para equipos con configuraciones complejas.
- Permite al usuario habilitar o deshabilitar señales individuales para controlar el volumen de datos y los costos.
- Documenta el formato del endpoint (gRPC/HTTP), las cabeceras requeridas y la semántica de los atributos y esquemas de cada señal, para que los usuarios puedan confiar en los datos que reciben en sus backends.
- Escoge una topología para el Collector: uno por tenant para ofrecer aislamiento, o uno compartido con pipelines por tenant para reducir la carga operativa.
- Proporciona ejemplos de configuración o variables de entorno para que los usuarios puedan empezar rápidamente.
Estos puntos también resumen las reglas de oro que siguen Cloudflare (excepto para métricas), Heroku, Kuma y Keycloak: enviar datos por defecto, mantener la independencia del proveedor y documentar el contrato.
Diseñar para las tres señales con estándares abiertos desde el inicio elimina fricción, reduce el trabajo de ingeniería y permite a los clientes aprovechar sus datos según sus necesidades.
Si estás leyendo esto como usuario final y no como desarrollador de un producto: no necesitas esperar a que tu proveedor SaaS adopte este enfoque.
Pídele que permita exportar mediante OTLP directamente. Es una petición razonable y cada vez más común, y ahora puedes usar esta publicación como referencia.