より高速で小さなチェックポイント: File Log レシーバーが protobuf を採用
File Log レシーバーを storage エクステンションと一緒に使っている場合、Collector はログファイルをポーリングするたびにチェックポイントを書き込みます。
このチェックポイントは、レシーバーがどこまで読み取ったかを記憶するためのもので、再起動してもログの欠損や重複が発生しないようにします。
長年にわたり、このチェックポイントのフォーマットは JSON でした。
OpenTelemetry Collector Contrib v0.164.0 以降、チェックポイントは常に protobuf で書き込まれます。 ベンチマークでは、チェックポイントの保存は約5倍高速になり、読み込みは5倍超高速になり、チェックポイント自体のサイズは約35%小さくなりました。
なぜチェックポイントの最適化に価値があったのか
File Log レシーバーは、追跡するファイルごとに小さなレコードを保持しています。 ファイルの先頭バイトから構築されたフィンガープリント、読み取りオフセット、レコード番号、ファイル属性、そして部分的な行をフラッシュするための状態です。 ストレージが設定されている場合、このリスト全体がポーリングサイクルの終わりにシリアライズされてストレージエクステンションに書き込まれ、レシーバーの停止時にもう一度書き込まれます。 読み戻されるのはレシーバーの起動時の一度だけです。
デフォルトの poll_interval が 200 ms であるため、Collector が稼働している間は毎秒5回の書き込みが発生します。
数百のコンテナログファイルがある Kubernetes ノードでは、書き込みのたびに数百のレコードがシリアライズされます。
2025年10月、あるユーザーが Issue を報告しました。
file_storage を使って Kubernetes ログを収集している Collector が、同様の処理を行う Fluent Bit と比べて著しく多くのリソースを消費していたのです。
プロファイリングの結果、チェックポイントの JSON エンコードに驚くほどの CPU が使われていることが判明しました。
JSON と protobuf の比較
JSON は人がデータを読む必要がある場合に優れています。 チェックポイントを読むのはレシーバーだけなので、JSON は不要なコストを払っていました。
最大のコストはファイルのフィンガープリント、つまり各ファイルの先頭 1,000 バイトです。 JSON は生のバイト列を保持できないため、テキストに変換されていました。 これによりサイズが約3分の1大きくなり、保存と読み込みのたびに変換をやり直す必要がありました。 さらに、レコードごとに同じフィールド名が繰り返され、数値やタイムスタンプもテキストとして書き出されていました。
protobuf はコンパクトなバイナリフォーマットです。 フィンガープリントをそのまま保存し、フィールド名のかわりに小さな数値タグを使い、数値は数値のまま保持します。 追跡ファイル1つあたりのチェックポイントサイズは 1,818 バイトから 1,186 バイトになり、書き込みと読み込みに必要な処理も大幅に減ります。
この作業は #45097 でマージされ、#52037 でチェックポイントの書き込みに使われる唯一の方式となりました。 正式に採用する前に、本番環境で実行しているユーザーにフィードバックを求めましたが、問題は報告されませんでした。
数値で見る改善効果
pkg/stanza/fileconsumer のチェックポイントコードに付属するベンチマークを使用しました。
各ベンチマークでは、1、10、100、1,000 ファイルについて、それぞれ 1,000 バイトのフィンガープリントと5つのファイル属性を持つ現実的なメタデータを構築し、インメモリストレージに保存します。
同一バイナリで JSON と protobuf のエンコードを交互に10回ずつ実行し、結果を benchstat で比較しました。
マシンは共有クラウド VM(4 vCPU Intel Xeon 2.80 GHz、linux/amd64、Go 1.26.0)です。 絶対的な数値はハードウェアによって異なりますが、ここで重要なのは比率です。
処理時間
| 操作(1,000 ファイル) | JSON | Protobuf | 変化 |
|---|---|---|---|
| エンコード(保存) | 15.38 ms | 3.21 ms | -79.15% |
| デコード(読み込み) | 28.18 ms | 5.01 ms | -82.22% |
| ラウンドトリップ | 44.04 ms | 8.54 ms | -80.61% |
改善効果は追跡ファイル数に依存しません。 protobuf は、ファイルが1つの場合から 1,000 ファイルの場合まで、JSON の4倍から6.5倍高速です。
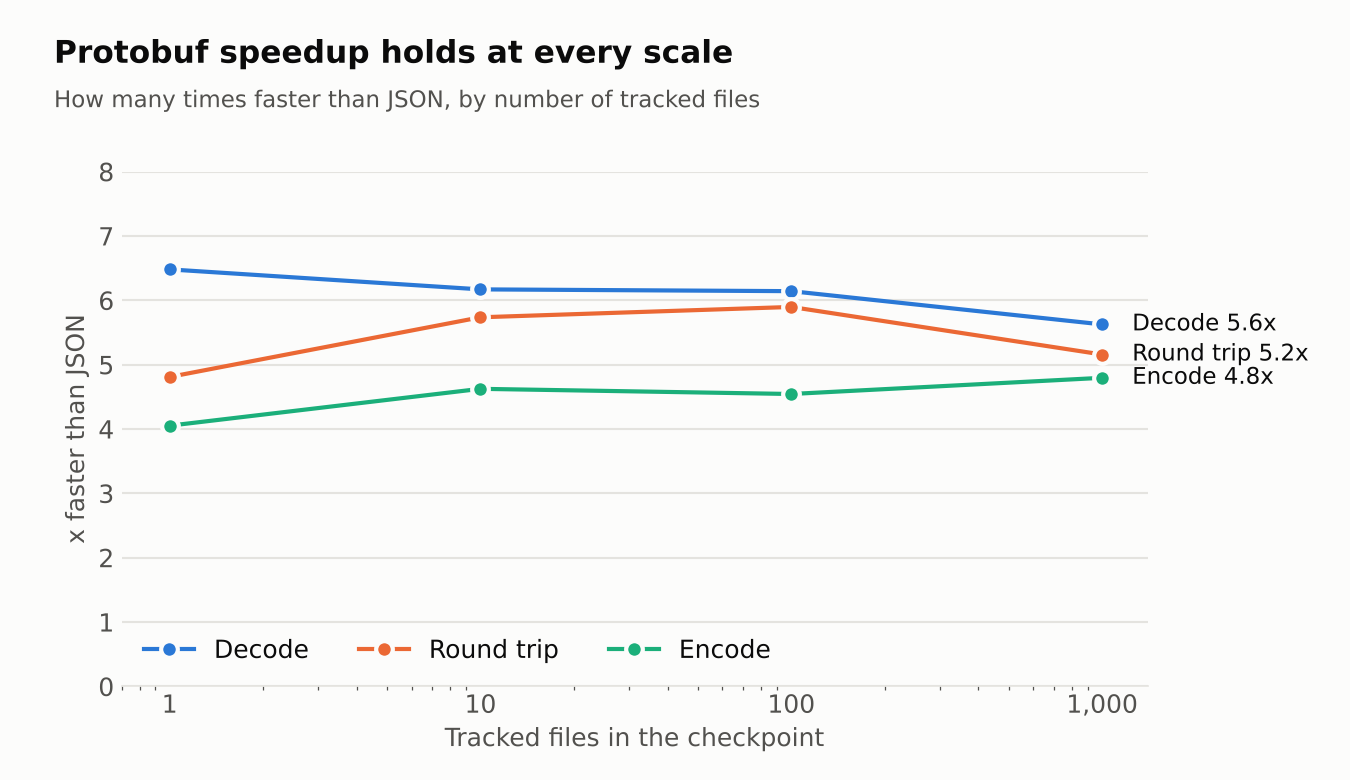
エンコードはポーリングのたびに実行されるため、最も重要な数値です。 具体的に言うと、1,000 ファイルを追跡して毎秒5回保存する場合、JSON ではチェックポイントだけで毎秒約 77 ms の CPU を消費していました。 protobuf ではこれが約 16 ms に下がります。 その差は、Collector がログのパースとエクスポートに使える CPU として還元されます。
サイズとメモリ
| 1,000 ファイル | JSON | Protobuf | 変化 |
|---|---|---|---|
| 保存されたチェックポイント | 1.740 MiB | 1.139 MiB | -34.58% |
| 保存あたりの割り当て | 5.807 MiB | 2.919 MiB | -49.74% |
チェックポイントは、テストしたすべてのファイル数で約35%小さくなります。
これは、file_storage が毎秒5回ディスクに書き込むデータが減ることを意味します。
保存あたりのメモリ割り当ても半分になるため、ガベージコレクターの負荷も軽減されます。
小さなトレードオフが1つあります。 protobuf では、各レコードがマーシャルされる前に protobuf メッセージに変換されるため、保存あたりのアロケーション回数が約10%から13%増加します。 ただし、個々のアロケーションは小さく、割り当てられる合計バイト数は依然として半分に減少するため、実用上はメリットの方が大きくなります。
必要な対応
ありません。 既存の JSON チェックポイントは Collector の起動時に引き続き読み込まれ、次の保存時に protobuf として書き直されるため、アップグレードは透過的で、読み取りオフセットはそのまま維持されます。
polls_to_archive 設定で使用されるアーカイブも同じエンコードを使用するため、同じ改善の恩恵を受けられます。
アップグレード後にチェックポイントに関して何か予期しない動作が見られた場合は、#43266 にコメントを残してください。